三维点云处理(十五):Mean-Shift 与 DBSCAN 密度聚类
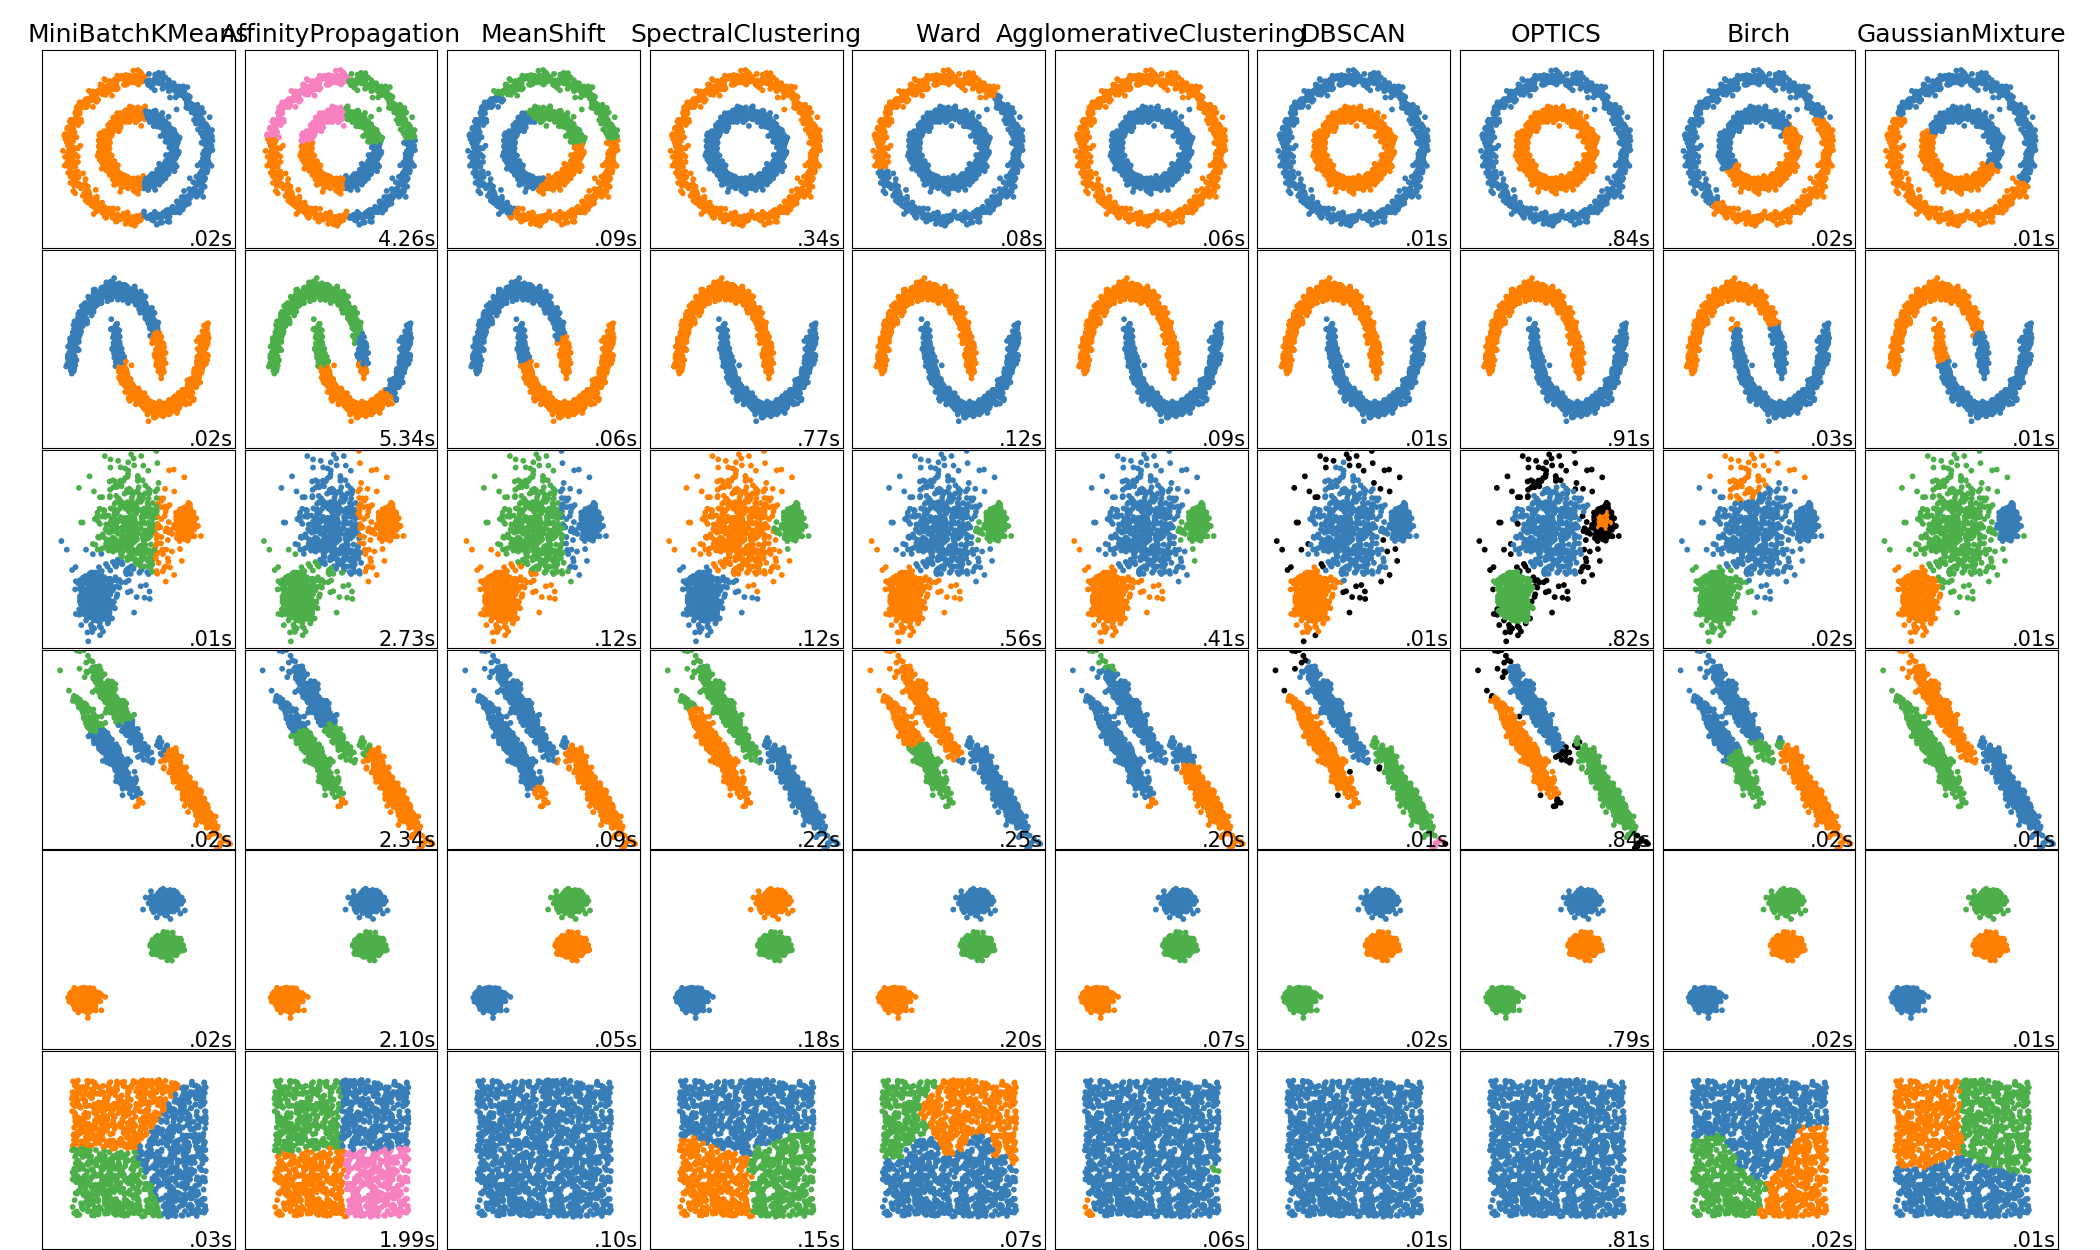
在处理真实场景的三维激光雷达(LiDAR)或 RGB-D 点云时,数据往往包含复杂的非凸几何形状、不均匀的密度分布以及大量的环境噪点。传统的 K-Means 和 GMM 算法必须预先指定簇数量 ,且难以适应任意形状的非凸聚类。
均值漂移(Mean-Shift) 与 DBSCAN(基于密度的噪声应用空间聚类) 作为两大经典的工程实用范式 (Practically Useful),无需预设 值,能够自动发现任意几何形状的簇并具备强大的抗噪能力。本章系统梳理这两种算法的数学原理与选型对比。
一、 均值漂移聚类 (Mean-Shift Clustering)
1.1 核心思想:概率密度爬山法 (Sliding Window Hill Climbing)
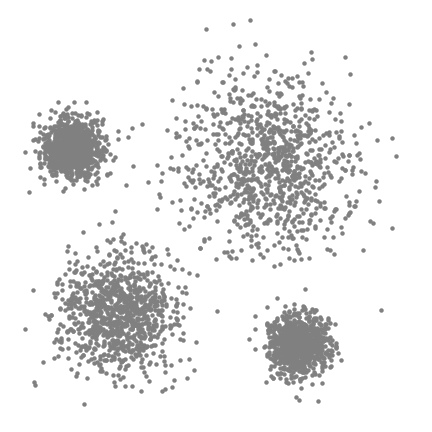
Mean-Shift 是一种基于核密度估计(Kernel Density Estimation, KDE)的非参数迭代算法。它将数据点在空间的分布视为一个概率密度函数,算法的核心思想是寻找概率密度的局部极值点(密度峰值 / "Hill")。
1.2 算法详细步骤
- 在数据空间中随机选择半径为 的超球体滑动窗口;
- 计算窗口内部包含的所有数据点的几何均值中心(质心):
- 将滑动窗口的中心平移向量移动至质心 ;
- 重复步骤 2 和 3,直到窗口中心不再发生显著位移(收敛至局部密度峰值);
- 遍历多个初始窗口,对收敛后相互重叠的超球体进行合并与去重(若多个窗口重叠,保留包含数据点最多的窗口);
- 根据各个点最终收敛到的密度峰值质心,将数据点归入对应的簇。
1.3 复杂度与优缺点
- 计算复杂度:,其中 为滑动窗口数量, 为利用 KD-Tree / Octree 进行半径搜索的开销。
- 算法优点:
- 自动确定簇的数量 ;
- 仅需设定单一超参数半径 ;
- 对离群噪点具有良好的鲁棒性。
- 算法缺点:
- 爬山过程容易陷入局部极小值;
- 强烈依赖初始窗口的选择与超参数 ;
- 隐式假设簇呈各向同性椭圆/球形;
- 主要适用于低维欧氏空间,高维数据下计算效率急剧下降。
二、 DBSCAN 密度聚类算法
DBSCAN (Density-Based Spatial Clustering of Applications with Noise) 是最著名的基于密度的聚类算法。它通过定义密度的连通性,能够识别任意非凸几何形状的簇,并显式地将孤立点标记为噪声。
2.1 三大节点类型定义
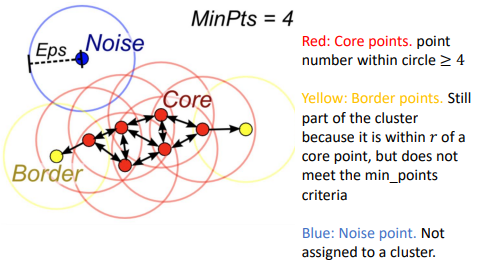
DBSCAN 基于两个超参数:搜索半径 (Eps) 与 最小邻域点数阈值 (min_samples)。
| 节点类型 | 严格数学定义 | 几何直观含义 | 聚类处置 |
|---|---|---|---|
| 核心点 (Core Point) | 其半径 超球邻域内的点数 $ | N_r(p) | \ge \text{MinPts}$ |
| 边界点 (Border Point) | 点数 ,但在某个核心点的 邻域内 | 位于簇边缘的边界点 | 附属于其邻近的核心点簇 |
| 噪声点 (Noise Point) | 既不是核心点,也不在任何核心点的 邻域内 | 孤立飞点或环境噪声 | 显式标记为噪声剔除 |
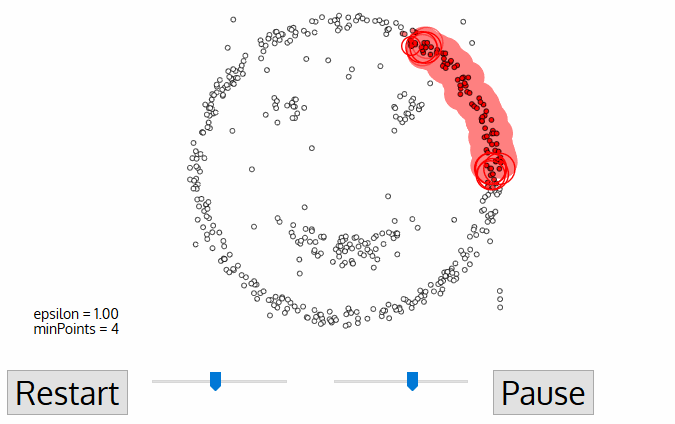
2.2 DBSCAN 算法执行流程
- 初始化:将点云中的所有点标记为
unvisited(未访问); - 检索与判定:随机选择一个未访问点 ,利用 KD-Tree 检索以 为中心、半径为 的超球邻域:
- 若邻域点数 ,标记 为
核心点,创建一个新簇 ,并将 的邻域点加入候选队列; - 若邻域点数 ,暂时将 标记为
噪声点;
- 若邻域点数 ,标记 为
- 簇的深度扩展:遍历候选队列中的每个点 :
- 若 未被访问,标记为已访问,并检查其 -邻域。若 也是
核心点,则将其邻域点合并加入候选队列; - 若 尚未归属于任何簇,将其标记归入当前簇 ;
- 若 未被访问,标记为已访问,并检查其 -邻域。若 也是
- 循环终止:当前簇 无法再扩展时,重新随机选择未访问点重复步骤 2~3,直到所有点均被访问。
2.3 复杂度与优缺点
- 计算复杂度:(结合 KD-Tree 进行半径 Nearest Neighbor 搜索)。
- 算法优点:
- 无需假设簇形状:能够轻松分割双环、螺旋、蛇形等任意非凸几何拓扑点云;
- 自动估计簇数 ;
- 强抗噪能力:显式分离环境飞点与噪声。
- 算法缺点:
- 无法处理密度悬殊的点云:DBSCAN 假设高密度簇由低密度区域分隔,若不同物体点云密度差异极大(如激光雷达近处极密、远处极稀),单一固定半径 会失效;
- 难以适应高维特征空间。
2.4 工程实战:自动驾驶 LiDAR 障碍物聚类的“黄金标准”
在自动驾驶感知管线中(非深度学习方案),经过地面滤除(Ground Removal)后的点云是一堆散乱的、且数量未知的悬浮物。DBSCAN 是此时进行障碍物实例分割(聚类出车辆、行人、树木包围盒)的绝对核心与工业界黄金标准。
核心调参经验:
- 搜索半径 (Eps):这是最致命的参数。LiDAR 点云存在“近密远疏”特性。
- 设定过小:远处的稀疏车辆会被无情地切碎成多个碎片(严重过分割 Over-segmentation)。
- 设定过大:等红灯时靠得很近的两辆车,或紧贴路牙的人行道行人,会被粘连融合成一个巨大无比的怪物簇(严重欠分割 Under-segmentation)。
- 工业界进阶解法:标准的固定半径 DBSCAN 无法完美兼顾远近,实战中通常采用 自适应 DBSCAN (Adaptive DBSCAN),即让搜索半径 随着距离雷达中心的径向距离 线性或非线性动态增大。
- 最小邻域点数 :不宜设置过高。通常取 3 ~ 10。如果设置过高,远处的行人(可能只有零星 4 个点)会被错误地当作噪声剔除,导致严重的漏检危机。
三、 五大经典聚类算法全景对比
将全书介绍的五大核心聚类算法对比总结如下:
| 算法名称 | 距离/相似度测度 | 簇数量 设定 | 对离群噪点鲁棒性 | 高维数据适应性 | 计算复杂度 | 适用的几何分布 |
|---|---|---|---|---|---|---|
| K-Means | 欧氏距离 | 需预先指定 | 差(易被孤立点拉偏) | 中等 | 凸集各向同性球形簇 | |
| GMM (高斯混合) | 欧氏距离 / 协方差 | 需预先指定 | 中等 | 中等 | 凸集各向异性椭球簇 | |
| Spectral (谱聚类) | 图连通性 / 相似度 | 启发式间隙确定 | 良好 | 良好 | 或 | 任意非凸拓扑流形 |
| Mean-Shift | 密度 / 欧氏距离 | 自动确定 | 良好 | 差 | 密度峰值凸分布 | |
| DBSCAN | 密度 / 欧氏距离 | 自动确定 | 极佳 | 差 | 任意非凸几何流形 |