三维点云处理(十一):K-Means 聚类原理与代码详解
K-Means 是最经典、最广泛使用的划分式聚类算法。在三维点云预处理、色彩量化、超体素生成与初始物体分割等任务中,K-Means 占据着基础且核心的地位。本章系统梳理 K-Means 的优化目标、EM 交替推导、工程加速技巧、数据压缩应用,以及其作为 GMM 高斯混合模型极限特例的数学证明。
一、 问题定义与畸变函数 (Distortion Measure)
1.1 优化目标
给定 个 维数据点 和预设的簇数 ,K-Means 引入两个变量:
- 簇中心(质心):
- 独热分配硬指标 (Hard Assignment Indicator):若 归属于第 个簇,则 ;否则 。
K-Means 的目标是寻找最优的质心集合 与分配矩阵 ,以最小化畸变函数(Distortion Measure / 簇内平方误差和 WCSS):
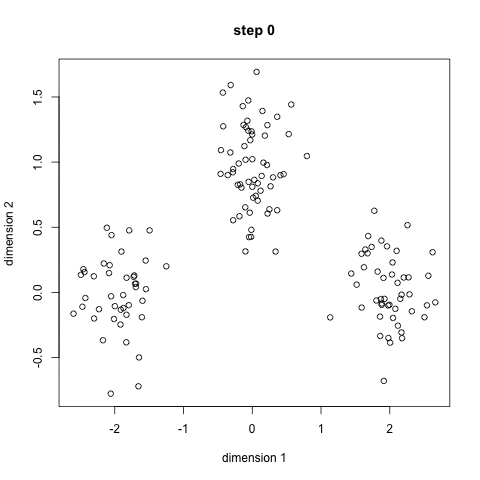
二、 算法推导:基于 EM 框架的 Lloyd 坐标下降
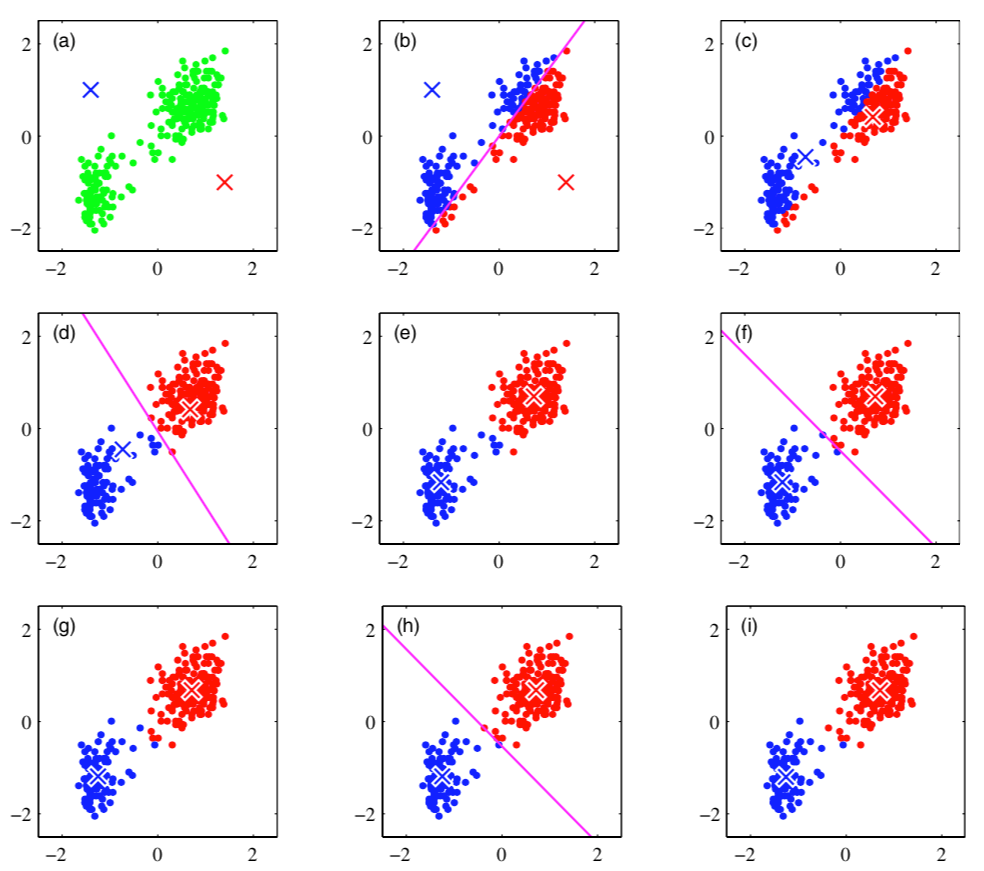
畸变函数 包含离散变量 与连续变量 ,无法通过求导一步得到解析解。Lloyd 算法采用交替优化(Coordinate Descent),这恰好对应于 EM (Expectation-Maximization) 算法的 E 步与 M 步:
2.1 E 步 (Expectation Step):固定 ,优化分配
由于各数据点 相互独立,对每个 可以分别求解:
显而易见,只有当 为距离 最近的质心索引时,取 才能使目标最小:
2.2 M 步 (Maximization Step):固定 ,更新质心
当分配关系 固定后,畸变函数 是关于 的二次可微凸函数。对每个质心 求偏导并令其为 0:
解得质心更新公式:
- 物理含义:新质心 恰好等于当前簇内所有样本点的几何平均值(质心重心)。
三、 实用变体与工程加速技巧
3.1 初始中心点选择对点云的敏感性分析与 K-Means++
局部极值陷阱与点云敏感性:K-Means 强烈依赖初始质心选择,极其容易收敛到次优的局部极小值。三维点云数据对初始化尤为敏感,原因在于:
- 空间极度稀疏:真实世界的点云包含大量空白区域。如果随机生成的质心落在两个物体的“中间空气”里,算法迭代时可能强行将两个物体的部分点撕裂。
- 密度极度不均:如自动驾驶 LiDAR 数据中,地面点极其密集,而远处的车辆极其稀疏。如果简单的“在数据点中随机抽 个点”作为初始质心,极有可能绝大多数质心都落在地面上,导致地面被过度分割,而所有稀疏车辆被迫合并为同一个簇。
解决策略:
- 多次随机初始化:随机运行 次(如 10 次),选择最终畸变函数 最小的一组结果;
- K-Means++ 空间对抗初始化 (推荐):核心思想是“初始质心应在空间上尽可能相互远离”。
- 步骤一:随机选取第一个数据点作为首个质心 。
- 步骤二:计算所有数据点 到当前已有质心集合的最短距离 。
- 步骤三:按概率 选择下一个质心。即距离已有质心越远的点,越大概率被选为新质心。
- 工程优势:由于采用了距离的平方项,K-Means++ 极大地降低了多个质心扎堆在地面或同一高密度物体的概率,完美契合了点云的空间分散特征。
3.2 增量更新与在线学习 (Sequential Update / Online K-Means)
对于大规模点云流数据,每读入一个新的点 ,找到其最近质心 ,并按学习率 实时更新:
3.3 小批量 K-Means (Mini-Batch K-Means)
每次迭代时不遍历全量 个点,而是随机抽取固定 Batch Size(如 1000 个点)进行 E 步与 M 步更新。显著降低单次迭代计算开销,加速收敛。
3.4 K-Medoids 算法 (中心点聚类)
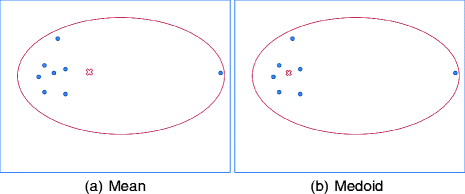
- 标准 K-Means 的缺点:均值质心 容易受到离群点(Outliers)的严重拉偏;且强制要求空间定义欧氏距离 范数。
- K-Medoids 改进:强制要求簇中心 必须是点集中实际存在的数据点,并允许使用任意异质性度量 (如曼哈顿距离、测地距离)。
| 算法对比 | 簇中心定义 | 距离测度 | 对噪声/离群点鲁棒性 | M 步计算复杂度 |
|---|---|---|---|---|
| K-Means | 几何均值质心(虚构点) | 欧氏距离 | 差(易被孤立点拉偏) | |
| K-Medoids | 实际数据样本点 | 任意不相似度 | 强 | 离散检索 |
四、 点云与图像压缩应用 (K-Means Compression)
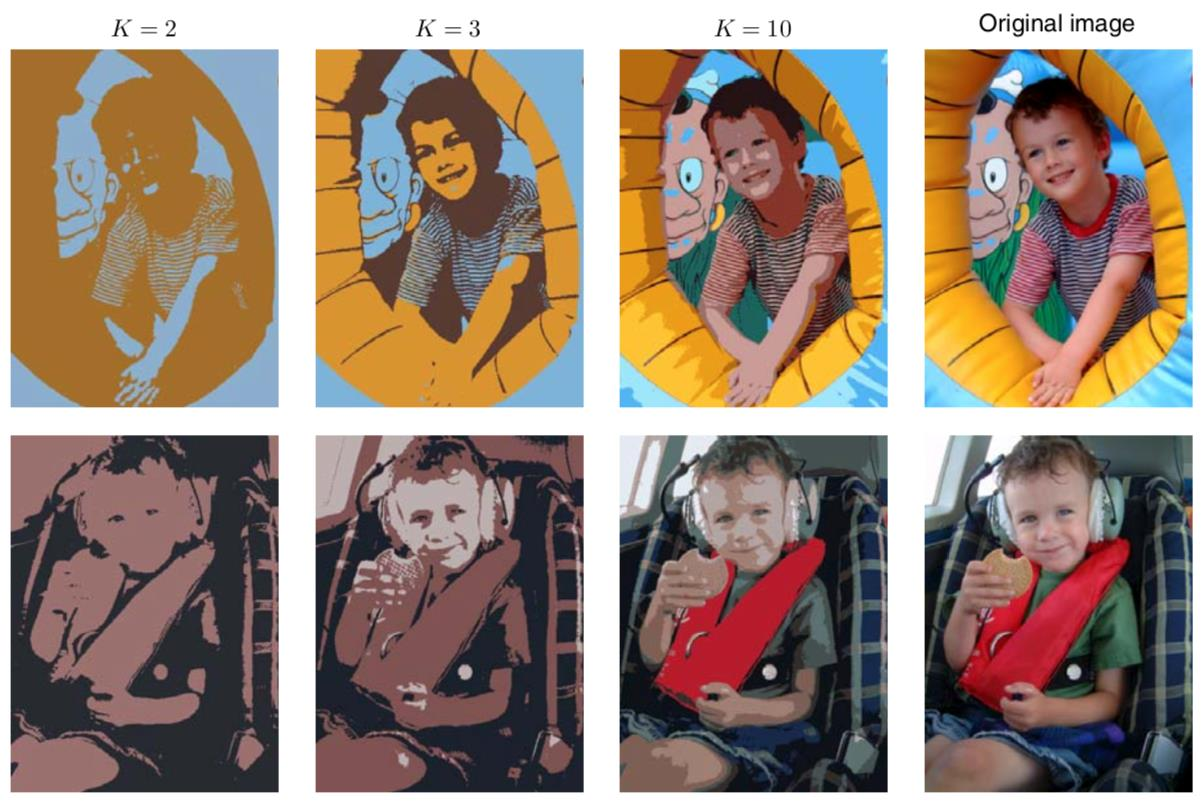
利用 K-Means 的矢量量化(Vector Quantization)特性,可将包含彩色信息的点云(XYZRGB)或 RGB 图像进行高效数据压缩。
压缩比特数计算推导
设原始 RGB 图像/点云包含 个像素/点,色彩占用 3 通道(每通道 8 bits,共 24 bits):
- 原始数据存储开销:
- 压缩后数据存储开销:
- 个质心的色彩表:;
- 个数据点的簇标签索引(用 bits 编码 个整数):;
- 压缩后总开销:。
由于 ,压缩比大约为 ,在大幅精简数据量的同时保持了整体几何色彩呈现。
五、 K-Means 作为 GMM 的极限特例推导
K-Means 与 GMM (高斯混合模型) 并非割裂的算法。K-Means 实际上是 GMM 当协方差矩阵趋于零()时的各向同性硬分配极限。
证明推导过程
在 GMM 中,数据点 属于第 个高斯分布的后验概率(软分配责任度)为:
假设各高斯成分具有相同的各向同性协方差矩阵 ,带入高斯密度公式:
分子分母约去常数项得:
当方差 时:
- 分母指数项中,距离最小的项 其指数衰减最为缓慢;
- 其他所有距离更大的 项由于 更加剧烈地趋于 ,其指数项 以极快速度衰减至 0。
因此,当极限 时,软分配后验概率坍缩为硬分配指标 :
同理,将 与 带入 GMM 的 M 步对数似然期望,常数项之外的优化目标正好退化为 K-Means 的畸变函数 。
六、 总结与算法优缺点
| 维度 | 特性总结 |
|---|---|
| 计算复杂度 | ,其中 为迭代次数, 为点数, 为簇数, 为维度 |
| 算法优点 | 原理简单直观、运行速度极快、易于并行与大规模工程实现 |
| 算法缺点 | 1. 强假设簇为球形各向同性分布(各方向方差相同); 2. 需预先指定簇数量 ; 3. 对初始值与离群噪点极度敏感; 4. 无法处理非凸流形结构(如双环、双月形点云)。 |