三维点云处理(十):聚类算法简介与数学预备知识
聚类(Clustering)是将未标记的数据点集按照相似性划分成若干个“簇(Cluster)”的无监督学习过程。在前几章中,我们学习了 PCA 的空间特征提取与 KD-Tree 结构检索。本章作为聚类专题的第一篇,系统梳理聚类的核心定义与算法分类框架,并推导理解 K-Means、GMM、EM 和谱聚类所必需的四大数学预备知识(线性代数、概率论、图模型与拉格朗日乘子法)。
一、聚类算法概述 (Introduction to Clustering)
1.1 聚类的定义
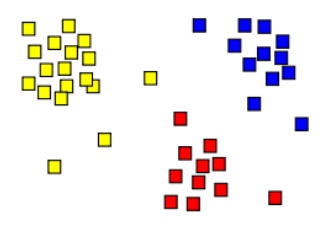
给定 个数据点 ,聚类的目标是寻找一种划分方案,使得:
- 簇内内聚性高(Cohesion):同一簇内的点尽可能相似(距离小);
- 簇间分离性高(Separation):不同簇之间的点尽可能不相似(距离大)。
1.2 聚类算法的分类体系
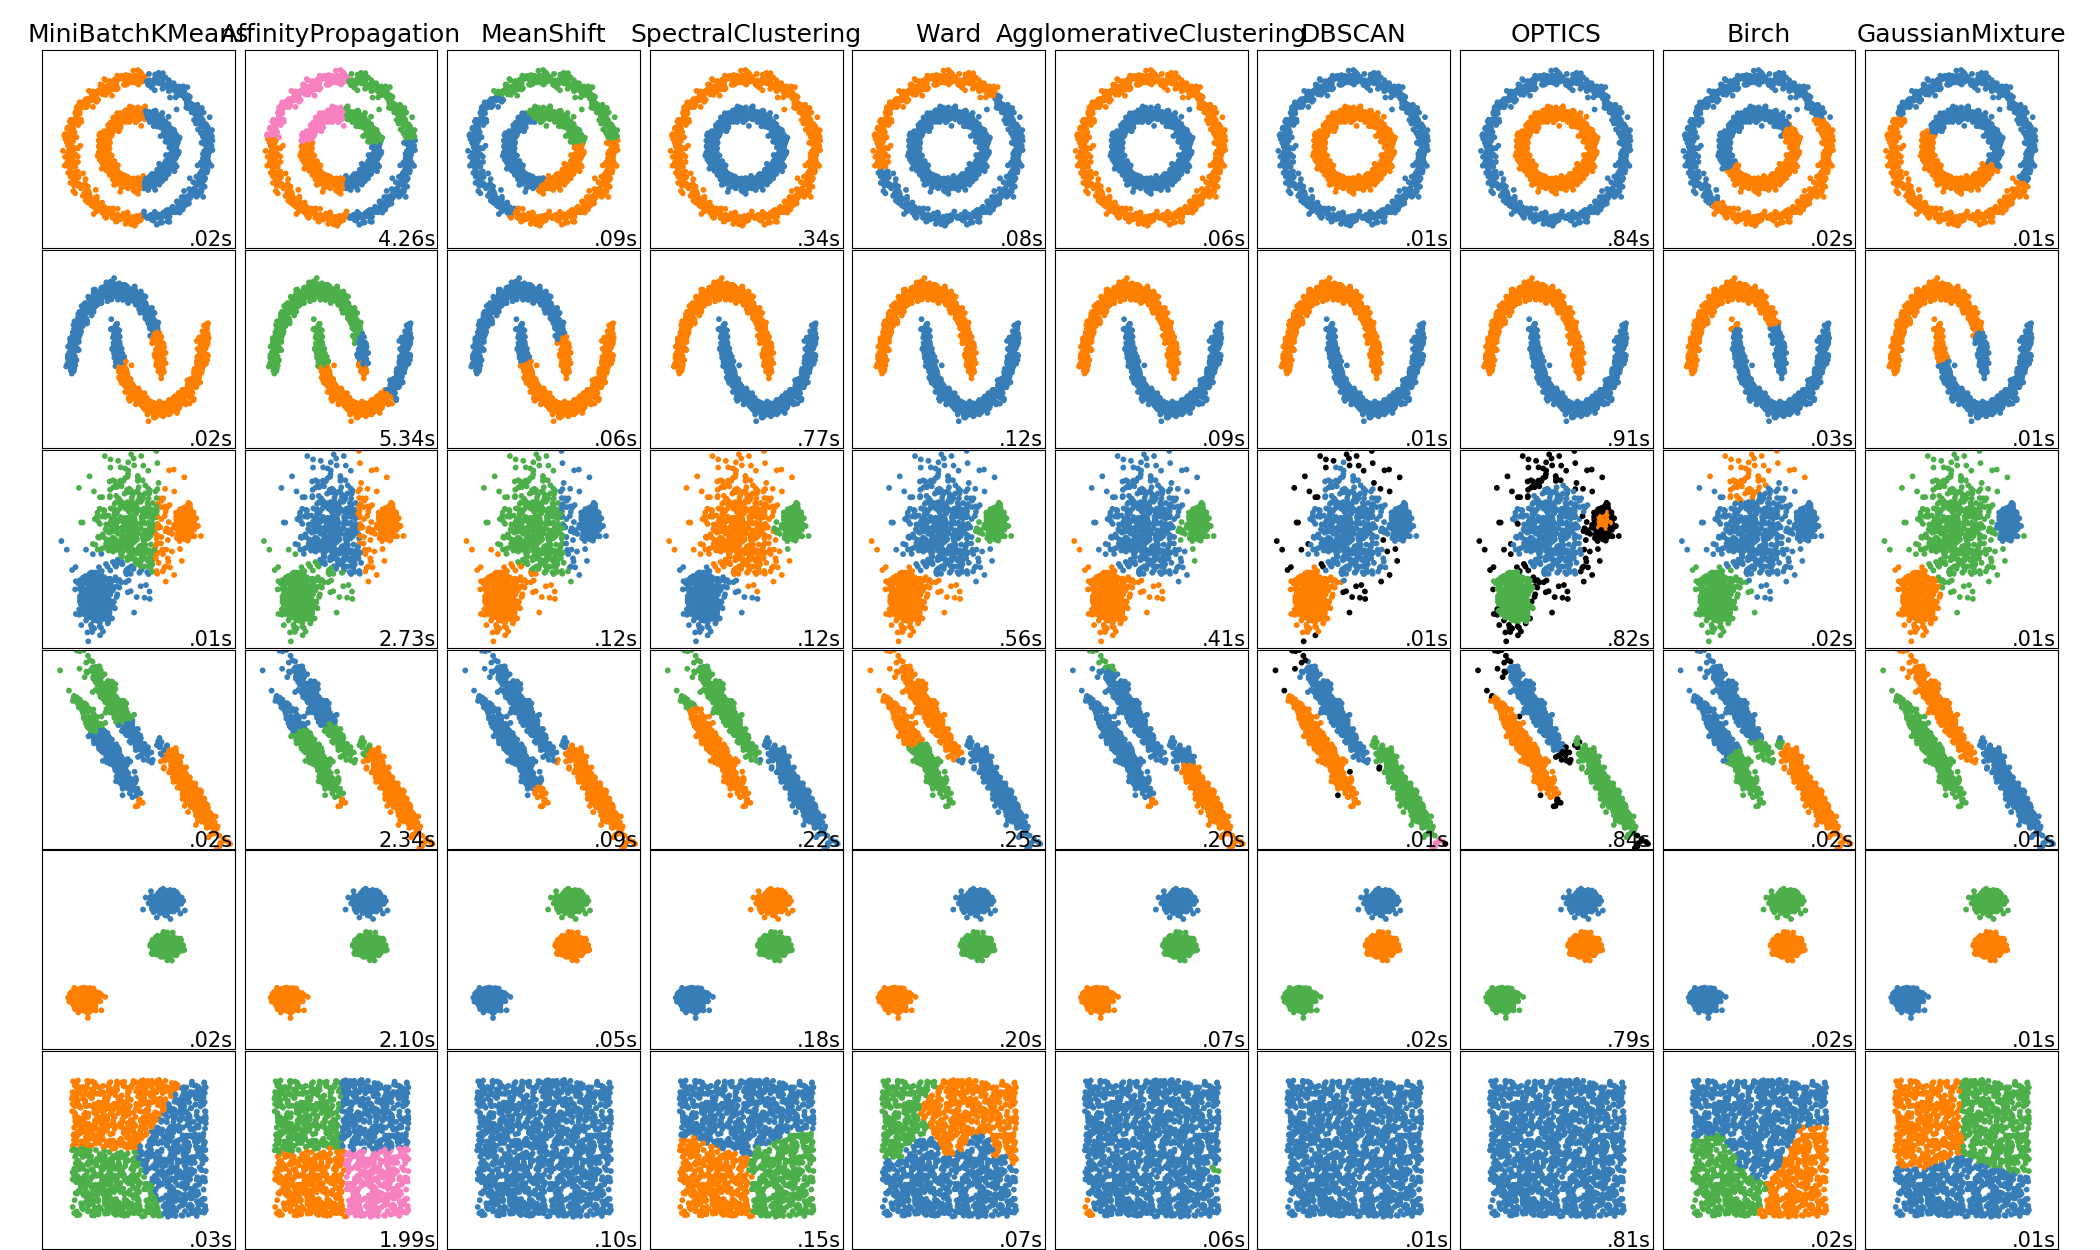
根据理论推导深度与工程实用性,点云及通用聚类算法主要分为两大范式:
| 范式类别 | 代表算法 | 核心特征与适用场景 |
|---|---|---|
| 理论深厚范式 (Theoretically Profound) | K-Means GMM (高斯混合模型) EM (期望最大化) Spectral Clustering (谱聚类) | 数学推导严密、建立在概率模型、优化理论或图论谱分析之上,适合分析凸集分布或特定流形结构。 |
| 工程实用范式 (Practically Useful) | Mean-Shift (均值漂移) DBSCAN (密度聚类) | 无需预设簇数量 ,能自适应发现任意形状的非凸簇并有效抵抗噪声。 |
1.3 聚类在三维工程中的意义与核心挑战
工程意义: 在自动驾驶、机器人抓取、工业缺陷检测中,纯粹的点云只是一堆无序的 XYZ 坐标。聚类是实现从“底层连续几何”到“高层独立语义实体”跨越的第一步:
- 自动驾驶障碍物提取:从地面被滤除后的激光雷达点云中,将空间连通的点聚合成车辆、行人的实例包围盒(Bounding Box)。
- 机器人无序抓取:在散乱的零件料框中,将互相接触但属于不同独立个体的零件剥离开来,为后续的 6D 位姿匹配提供实例输入。
- 大场景点云管理:将大规模城市场景按几何连通性分割成独立的建筑物、树木簇,从而实现按需加载与高效渲染。
三维聚类的核心挑战:
- 密度极度不均(Varying Density):LiDAR 扫描的点云“近密远疏”。基于固定距离阈值的算法(如标准 DBSCAN)往往在近处表现完美,但在远处会将一辆稀疏的车断裂切割成多个无意义的簇(过分割)。
- 缺乏拓扑结构(Unorganized):点云不像图像那样具备天然的 2D 像素网格邻接关系。因此,任何 3D 聚类算法的底层都必须强依赖 KD-Tree 或 Octree 进行极高频的半径搜索或 K-NN 搜索,算法复杂度极容易爆炸。
- 环境噪声与遮挡(Noise & Occlusion):雨雾、多径反射产生的“鬼影飞点”可能像桥梁一样将两个本该独立的物体连接在一起,导致严重的欠分割(Under-segmentation)。
二、预备知识 1:线性代数 (Linear Algebra)
2.1 谱定理 (Spectral Theorem)
对于任意 的实对称矩阵 ,必定存在 个实特征值 和一组标准正交特征向量 (满足 且 )。
矩阵 可进行特征分解(谱分解):
2.2 瑞利商 (Rayleigh Quotient)
对于实对称矩阵 ,定义向量 的瑞利商 为:
- 取值范围定理:瑞利商的值有界于矩阵 的最小特征值与最大特征值之间:
- 极值取到条件:
- 当向量 为最大特征值对应的特征向量 时,取得最大值:
- 当向量 为最小特征值对应的特征向量 时,取得最小值:
物理与优化意义:瑞利商是 SVD 奇异值分解与谱聚类(Spectral Clustering)中图拉格朗日矩阵切分的目标优化基础。
三、预备知识 2:概率论与条件概率 (Probability Theory)
3.1 联合概率 (Joint Probability)
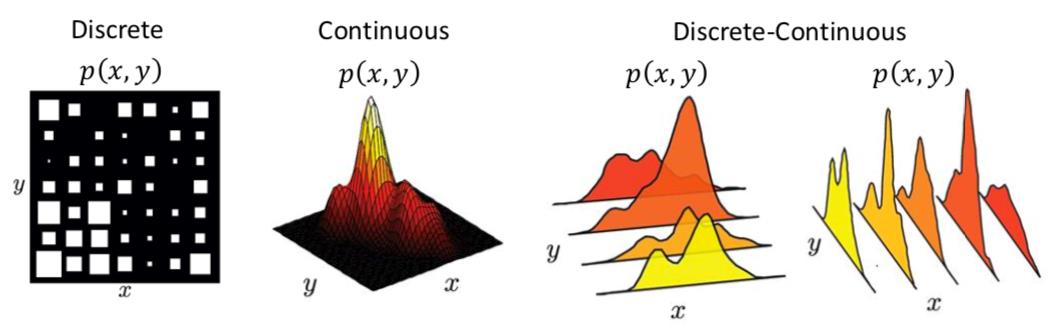
考虑随机变量 与 的联合事件分布 ,表示 且 同时发生的概率。可以推广到任意多维随机变量 。
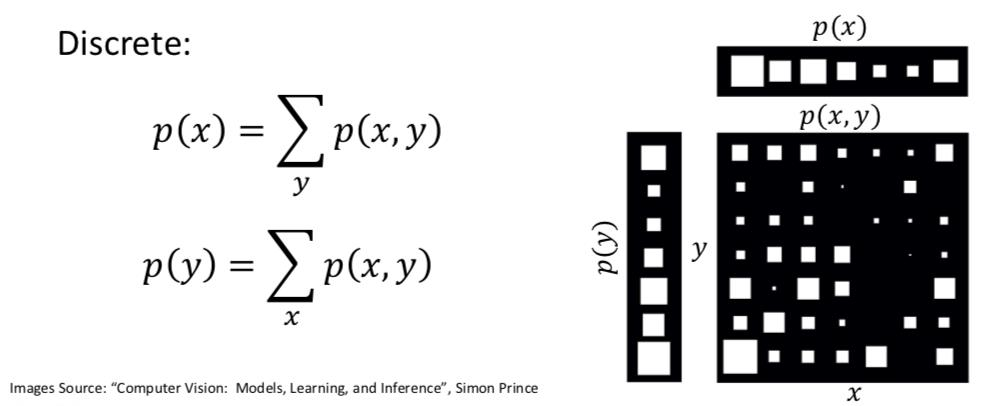
3.2 边缘化与加法法则 (Marginalization / Sum Rule)
通过对联合分布在其他无关变量上进行积分(连续变量)或求和(离散变量),可以还原出单个变量的边缘概率分布:
- 连续型:
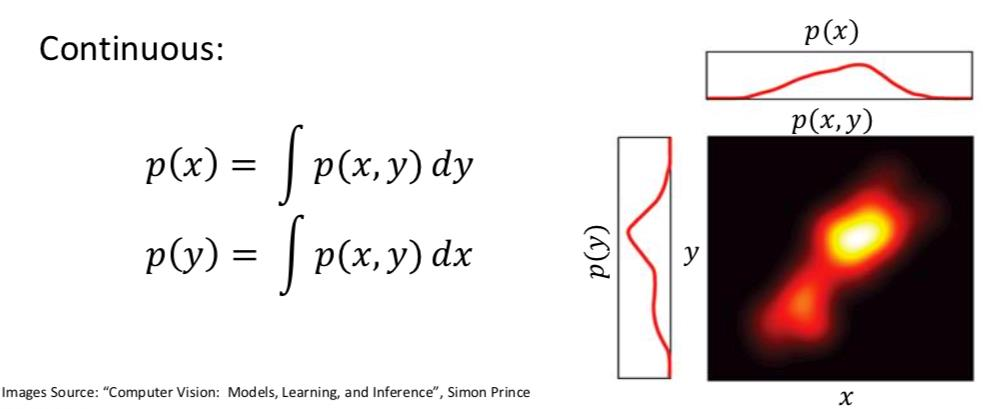
- 离散型:
3.3 条件概率与乘积法则 (Conditional Probability / Product Rule)
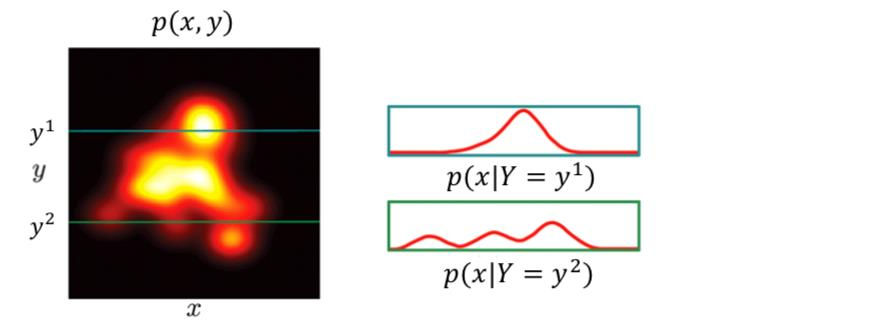
已知 条件下,随机变量 的条件概率分布定义为:
由条件概率可推导出概率论中的乘积法则 (Product Rule):
乘积法则可以链式推广到高维随机变量空间:
四、预备知识 3:图模型 (Graphical Modeling)
图模型用节点(Node)表示随机变量,用边(Edge)表示变量之间的依赖/条件概率关系。
4.1 有向图模型 (Directed Graphical Model, DGM / 贝叶斯网络)
- 结构:由有向图 表示,节点 代表随机变量,有向边 代表条件概率因果关系。
- 马尔可夫假设 (Markov Assumption):给定一个节点的父节点(Parents),该随机变量与其所有非后裔节点(Non-descendants)条件独立。
- 联合概率分解:例如变量 ( 为隐藏类别/年龄, 为观测数据/头发颜色),其联合概率分布展开为:
4.2 无向图模型 (Undirected Graphical Model, UGM / 马尔可夫随机场 MRF)
- 结构:由无向图 表示,边没有方向性,表示节点之间的对称相互作用。
- 应用场景:常称为马尔可夫随机场(Markov Random Field, MRF)或马尔可夫网。用于点云图分割、网格平滑与路网/像素邻域关系建模。
五、预备知识 4:拉格朗日乘子法 (Lagrange Multipliers)
5.1 约束优化问题
考虑在等式约束条件 下,求解目标函数 的极值问题:
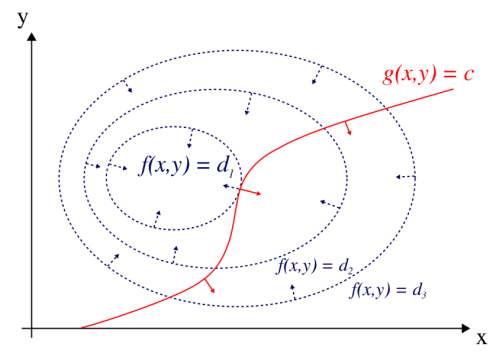
5.2 几何直觉与梯度平行
- 目标函数 的等高线(Level Sets)是在空间中分布的曲线/曲面。
- 约束条件 规定了变量只能在特定的红线/曲面上移动。
- 极值条件:在局部极值点处, 不能沿着约束切线方向继续增加。此时,目标函数 的梯度 与约束函数 的梯度 必须平行:
5.3 拉格朗日函数构建与求解
引入拉格朗日乘子 ,构造拉格朗日函数:
对其所有变量求偏导并令其为 :
在聚类算法中的应用:拉格朗日乘子法用于导出 K-Means 质心更新、GMM 权重混合系数 的约束求解、以及 PCA/谱聚类中二次型的特征值分解。
六、总结与后续章节铺垫
| 预备知识板块 | 包含核心概念 | 支撑的聚类算法 |
|---|---|---|
| 线性代数 | 谱定理、特征分解、瑞利商 | K-Means 优化分析、谱聚类 (Spectral Clustering) |
| 概率论基础 | 边缘化、条件概率、乘积法则 | GMM 高斯混合模型、EM 算法 |
| 图模型 (Graphical Model) | 有向图 (DGM)、无向图 (MRF) | GMM 隐变量表达、谱聚类的构图与图切分 |
| 拉格朗日乘子法 | 梯度平行、约束优化、拉格朗日函数 | K-Means、GMM、PCA 与谱聚类极值求解 |
在接下来的几章中,我们将基于这些数学基础,逐一深入推导并实现 K-Means、GMM / EM 算法、谱聚类(Spectral Clustering)以及 DBSCAN 与 Mean-Shift。