三维点云处理(六):点云滤波算法全景
滤波是三维点云数据预处理的核心步骤。原始传感器(如激光雷达 LiDAR、RGB-D 深度相机)采集的点云往往包含大量的环境离群点、毛刺噪声与冗余数据。滤波处理涵盖噪声去除 (Noise Removal)、降采样 (Downsampling) 以及 上采样与平滑 (Upsampling & Smoothing) 三大核心应用板块。
一、点云噪声分类与处理框架
| 噪声/数据问题 | 物理来源 | 典型几何特征 | 核心处理策略 |
|---|---|---|---|
| 飞点 / 孤立噪声 | 传感器遮挡边界、多次反射 | 远离主点云、邻域密度极低 | 半径离群点去除 (ROR) |
| 高斯散点噪声 | 传感器热噪声、量化误差 | 点沿真实曲面法向随机微小偏移 | 统计离群点去除 (SOR) / PCA 滤波 |
| 数据冗余与计算开销 | 传感器近距离过采样 | 点云极度密集、计算负担重 | 体素网格降采样 / 最远点采样 (FPS) |
| 边缘模糊与细节丢失 | 全局平滑降噪 | 边缘处曲率突变被磨平 | 双边滤波 (Bilateral Filter) |
二、噪声去除算法 (Noise Removal)
2.1 半径离群点去除 (Radius Outlier Removal, ROR)

1. 算法原理
半径出局点去除通过指定搜索半径 和邻域最小点数阈值 :
- 对点云中的每一个点 ,搜寻以 为球心、半径为 的超球体邻域 ;
- 统计邻域包含的点数 ;
- 若 ,则判定该点为孤立飞点或离群噪声并予以剔除。
2. 特征与应用
原理简单直观,能极为高效地剔除背景飞点与孤立噪声,但对固定半径 和阈值 敏感。
2.2 统计离群点去除 (Statistical Outlier Removal, SOR)
1. 算法原理
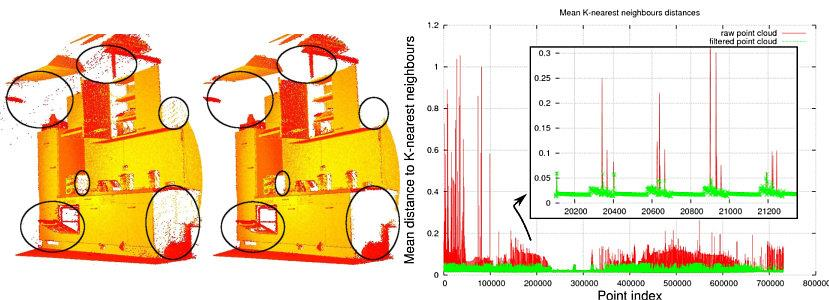
统计出局点去除是半径法的动态升级版。它利用邻域距离分布的高斯统计特性动态决定阈值:
- 对每个点 ,借助 KD-Tree 搜索其最近的 个邻域点,计算平均邻域距离 :
- 计算所有点的平均邻域距离的全局均值 与标准差 :
- 设定判定边界:若某点的平均邻域距离满足以下条件,则认定其为噪声点:其中 为标准差倍数因子(通常取 )。
三、点云降采样算法 (Downsampling)
降采样旨在减少点云数据量,降低后续匹配(如 ICP 配准)或识别算法的计算复杂度。
3.1 体素网格降采样 (Voxel Grid Downsampling)
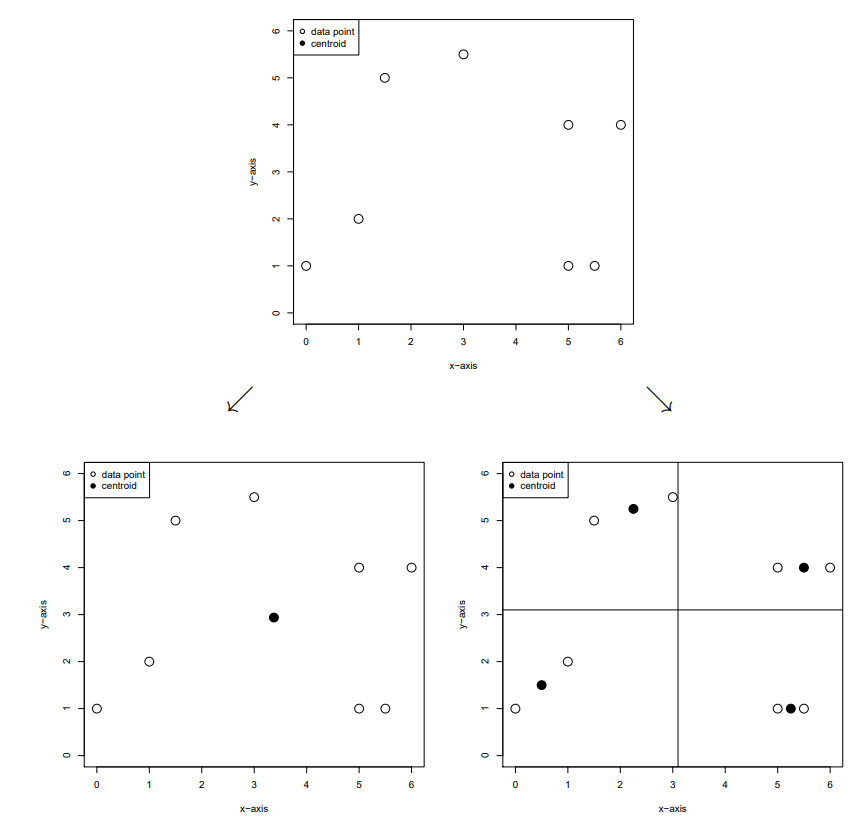
将点云所在的包围盒空间切分为边长为 的体素网格(Voxel)。每个体素网格内仅保留一个代表点。代表点的生成策略分为以下两种:
- 质心法 (Centroid Voxel Downsampling):计算网格内所有点坐标的几何平均值 。精确度高、可代表主要几何分布,但需注意若属性包含分类标签等非数值量,需改用投票机制。
- 随机采样法 (Random Voxel Downsampling):随机从网格中挑选一个原始点作为代表点。计算效率极高,但有极小概率选中体素边缘的异常孤立点。
3.1.1 精确体素网格算法实现流程
- 确定边界:计算点云的极值 ;
- 划分体素:根据分辨率 计算网格尺寸与网格坐标 ;
- 计算一维哈希索引与排序:一维索引 ,然后基于 对点云索引进行排序 ;
- 提取代表点:遍历同索引的点组,计算质心或抽取随机点。
工程陷阱防范:
- 数值溢出风险:在大空间范围、高分辨率场景下, 可能超出 32 位整数上限,必须使用 64 位整数(
int64)存储体素索引。- 排序弱序规范:比较函数必须使用严格小于(
<),否则在 C++ / Python 某些底层排序中会导致缓冲区越界崩溃。
3.1.2 基于哈希表的高效近似体素降采样 (Approximate Hash Downsampling)
针对车载激光雷达单帧十几万点数据的实时性需求,全局排序 耗时数毫秒。利用三维空间的稀疏性:
- 取模哈希映射:通过哈希函数将三维网格坐标直接映射至固定大小的容器数组 :
- 冲突随机覆盖:若检测到映射冲突,随机释放原容器内的点存入新点。
- 效果:比传统精确体素降采样快约 5 倍,极适合激光雷达 SLAM 的实时预处理。
3.2 最远点采样 (Farthest Point Sampling, FPS)
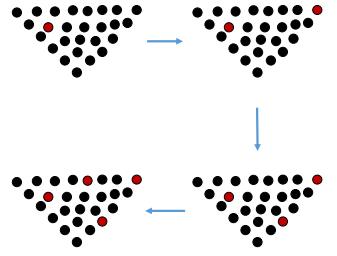
- 核心思想:迭代式采样。每次选取距离当前已采样点集中所有点最短距离的最大值对应的那个点。
- 算法步骤:
- 随机选择一个初始点加入集合 ;
- 计算剩余所有点到已选点集 的最短距离 ;
- 选择 最大的点加入 ;
- 重复步骤 2~3 直至采样点数达到目标 。
- 应用价值:采样点分布极佳地兼顾了空间均匀性与稀疏区域结构保留,是 PointNet++ 等三维深度学习预处理的标准算法。
3.3 法向量空间采样 (Normal Space Sampling, NSS)
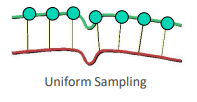
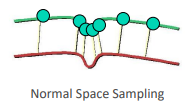
- 动机:点云配准(如 ICP 算法)极度依赖边缘、棱角等法向量突变区域的点。随机或均匀几何采样容易丢失这些关键特征。
- 算法方法:
- 将单位球面法向量空间按角度均匀分箱(如每 划分一个子区间);
- 将所有点按其法向量分类归入对应区间;
- 在每个法向量区间内抽取相同数量的样本点。
- 优势:保证了所有法线方向的代表点都能被均等保留,大幅提升配准收敛速度与稳定性。
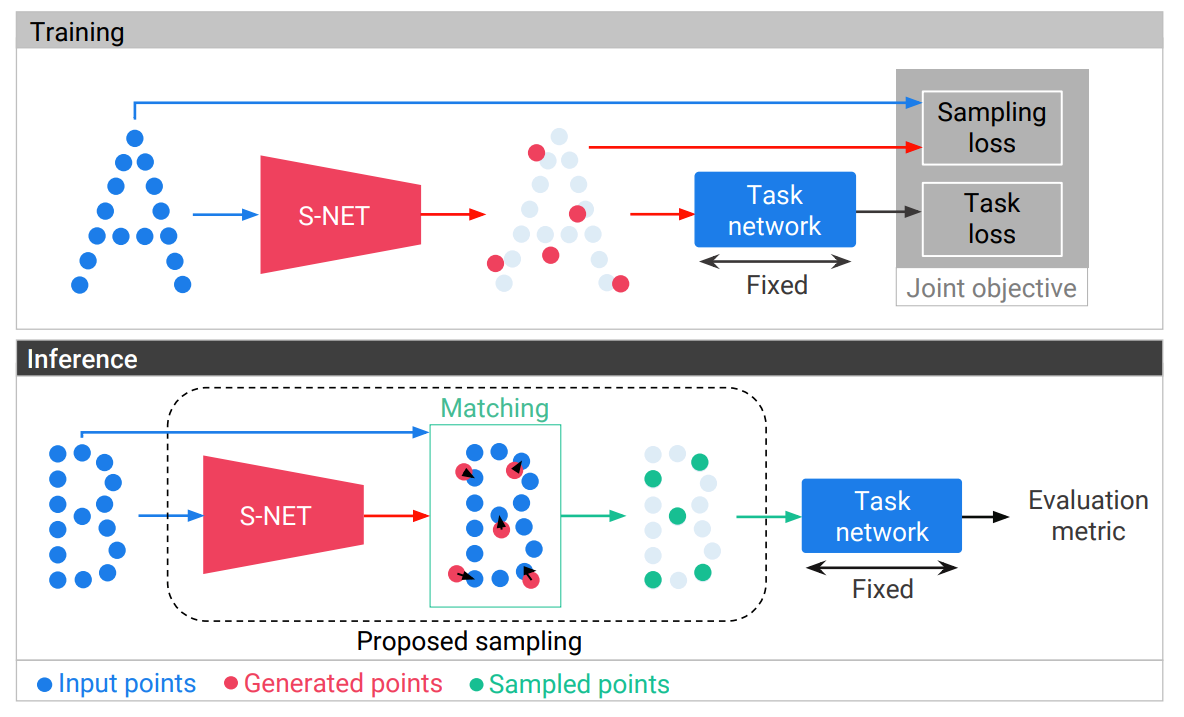
3.4 基于深度学习的自适应采样 (Learning to Sample)
传统采样方法基于单纯的几何均匀性,无法根据具体下游任务自适应保留关键语义特征。
- 网络架构:输入原始点云,通过轻量级神经网络输出降采样后的点集。
- 优化目标:
- 语义一致性:通过下游分类/分割网络的损失反向传播,确保在极低采样率(如 1024 点降至 8 点)下,采样后的点集仍能维持高分类准确率(如 83% 对比 FPS 的 61%);
- 几何约束:引入双向 Chamfer 距离(Chamfer Distance)约束降采样点集紧贴原始空间曲面。
四、 上采样与平滑降噪 (Upsampling & Smoothing)
4.1 双边滤波 (Bilateral Filter)
双边滤波是一种经典的**边缘保留平滑(Edge-preserving Smoothing)**算法。
1. 高斯滤波 vs 双边滤波
| 滤波类型 | 核心机制 | 应用效果 |
|---|---|---|
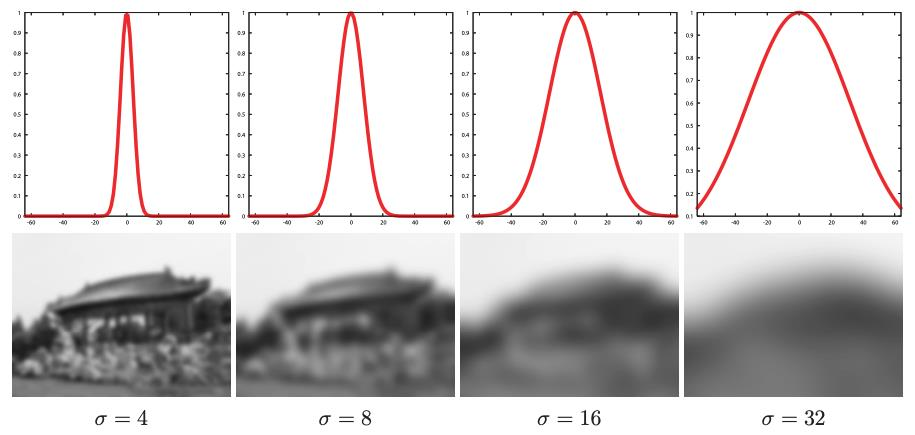
| 高斯滤波 | 仅基于空间几何距离加权平均 | 全局均匀模糊,导致边缘与细小结构磨平 |
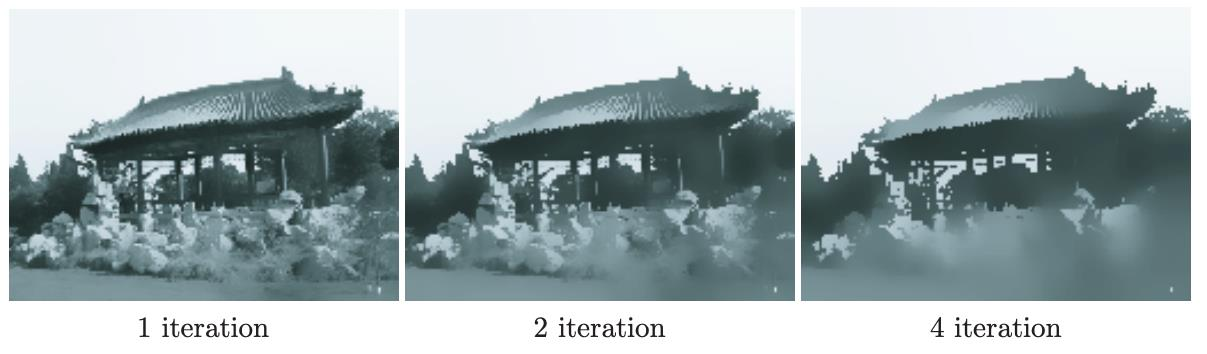
| 双边滤波 | 结合空间几何距离与属性相似度(颜色/深度/法向)双重高斯核 | 平滑表面噪声的同时,完美保留显著边缘 |
- 高斯滤波效果(模糊边缘):
- 双边滤波效果(保留结构边界):
2. 数学表达式
对于点 ,其双边滤波后的输出值 为邻域 的双重高斯核加权平均:
其中归一化因子 为:
- 空间高斯核 :控制空间几何近邻权重衰减;
- 属性高斯核 :控制颜色/深度/法向量差值的权重衰减。当 和 跨越边缘(属性差值大)时, 趋于 0,阻止跨边缘平滑。
4.2 双边滤波典型应用案例
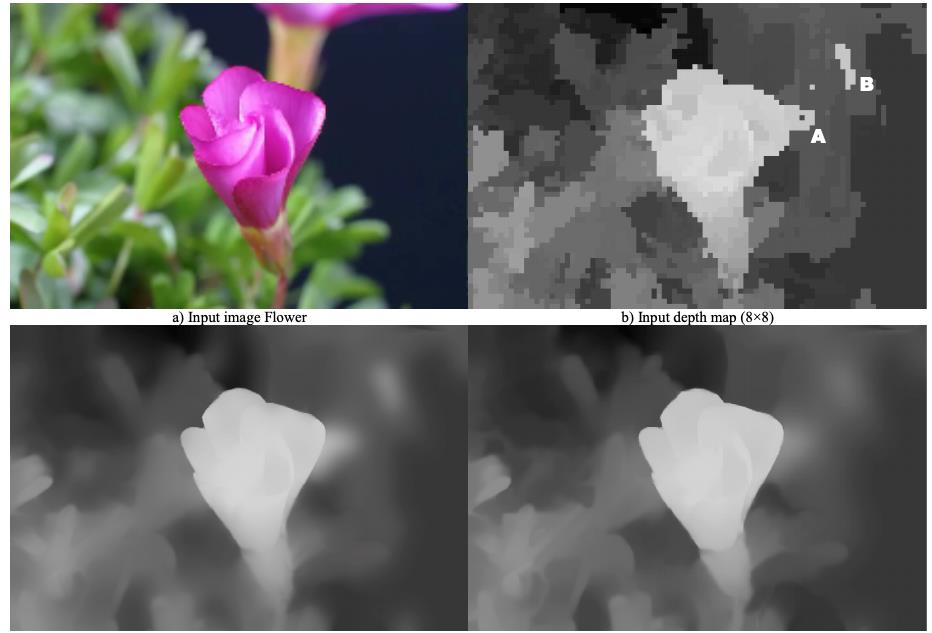
1. 案例一:RGB 图像引导的深度图平滑去噪
传感器或匹配算法初步估算的深度图通常包含大量的随机高频抖动噪声。
- 处理流程:通过 RGB 彩色图像的颜色信息引导双边滤波,结合空间核与颜色核的约束,在去除深度图噪声的同时保留物体的几何边缘。
- 效果对比:如下图所示,经过不同滤波参数处理后的深度图在保留主体结构的同时,表面深度值变得非常平滑清晰。
2. 案例二:KITTI 数据集多传感器融合与稀疏点云深度补全 (Depth Completion)
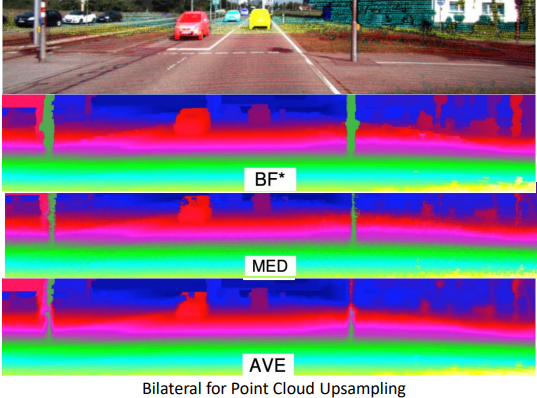
在相机与 3D 激光雷达(LiDAR)融合感知中,激光点云投影到图像平面后极其稀疏,导致大量像素缺失深度信息:
- 问题挑战:如下图中所示,前方的电线杆与远处的建筑物在 2D 图像上重叠紧邻,但在 3D 空间中实际相距较远。
- 传统高斯滤波缺陷:若采用纯空间距离加权的高斯滤波,电线杆的深度值会错误地扩散并赋予到远处建筑物的墙面上,导致电线杆边缘模糊或轮廓异常膨胀。
- 双边滤波解法:双边滤波的属性高斯核 能够感知电线杆与墙面之间的颜色差异,在颜色骤变边界自动将权重降为零,有效阻止跨越边界的错误深度赋值。
- 效果对比:在深度补全任务中,双边滤波在保持物体几何轮廓清晰度上显著优于均值滤波与中值滤波。
五、 Python 工业级代码实现
下面给出包含体素降采样(质心法/随机法)、最远点采样 (FPS)、统计离群点滤波与半径离群点滤波的完整 Python 实现:
import numpy as np
import open3d as o3d


def voxel_grid_downsample(points, voxel_size, method='centroid'):
    """
    精确体素网格降采样 (Voxel Grid Downsampling)
    :param points: N x 3 的点云坐标数组
    :param voxel_size: 体素尺寸 (float)
    :param method: 'centroid' (质心法) 或 'random' (随机采样法)
    :return: 降采样后的 M x 3 点云数组
    """
    if len(points) == 0:
        return points

    # 1. 计算点云边界极值
    min_bound = np.min(points, axis=0)

    # 2. 计算每个点对应的三维体素索引 (使用 64 位整数防溢出)
    voxel_indices = np.floor((points - min_bound) / voxel_size).astype(np.int64)

    # 3. 构建一维体素哈希键
    max_idx = np.max(voxel_indices, axis=0) + 1
    keys = (voxel_indices[:, 0] +
            voxel_indices[:, 1] * max_idx[0] +
            voxel_indices[:, 2] * max_idx[0] * max_idx[1])

    # 4. 按照体素键进行排序
    sort_order = np.argsort(keys)
    sorted_points = points[sort_order]
    sorted_keys = keys[sort_order]

    # 5. 分组提取代表点
    unique_keys, indices = np.unique(sorted_keys, return_index=True)

    downsampled = []
    for i in range(len(indices)):
        start_idx = indices[i]
        end_idx = indices[i + 1] if i + 1 < len(indices) else len(sorted_points)
        group = sorted_points[start_idx:end_idx]

        if method == 'centroid':
            downsampled.append(np.mean(group, axis=0))
        else:  # random
            idx_rand = np.random.randint(0, len(group))
            downsampled.append(group[idx_rand])

    return np.array(downsampled, dtype=np.float64)


def farthest_point_sampling(points, n_samples):
    """
    最远点采样 (Farthest Point Sampling, FPS)
    :param points: N x 3 的点云坐标数组
    :param n_samples: 需要采样的点数
    :return: n_samples x 3 的采样点云数组
    """
    N = len(points)
    if N <= n_samples:
        return points

    sampled_indices = np.zeros(n_samples, dtype=np.int32)
    distances = np.full(N, fill_value=np.inf)

    # 1. 随机选择第一个初始点
    farthest_idx = np.random.randint(0, N)

    for i in range(n_samples):
        sampled_indices[i] = farthest_idx
        centroid = points[farthest_idx]

        # 2. 计算所有点到新采入点的欧氏距离平方
        dist = np.sum((points - centroid) ** 2, axis=1)

        # 3. 更新所有点到当前已选点集的最短距离
        distances = np.minimum(distances, dist)

        # 4. 选择最短距离最大的点作为下一个采样点
        farthest_idx = np.argmax(distances)

    return points[sampled_indices]


def statistical_outlier_removal(pcd, nb_neighbors=20, std_ratio=2.0):
    """
    统计离群点剔除 (Statistical Outlier Removal)
    """
    cl, ind = pcd.remove_statistical_outlier(nb_neighbors=nb_neighbors, std_ratio=std_ratio)
    return cl, ind


def radius_outlier_removal(pcd, nb_points=16, radius=0.05):
    """
    半径离群点剔除 (Radius Outlier Removal)
    """
    cl, ind = pcd.remove_radius_outlier(nb_points=nb_points, radius=radius)
    return cl, ind
六、 总结与方法选型对比
| 滤波算法 | 优点 | 缺点 | 推荐应用场景 |
|---|---|---|---|
| 半径滤波 (ROR) | 原理直觉、针对孤立飞点极其有效 | 依赖固定的空间密度与半径 | 剔除空气飞点、背景离群噪点 |
| 统计滤波 (SOR) | 适应密度不均匀点云 | 计算局部 -NN 稍耗时 | 去除高斯分布噪点与扫线边沿点 |
| 体素网格降采样 | 保持均匀空间分辨率、计算速度快 | 无法感知局部特征陡变 | 激光雷达点云预处理、网格化 |
| 最远点采样 (FPS) | 几何覆盖极佳、保留稀疏细节 | 计算复杂度较高 | 深度学习网络 (PointNet++) 预处理 |
| 法向量空间采样 | 保留棱角与曲率突变结构 | 需先估计精确的法向量 | 点云配准 (ICP) 预处理 |
| 双边滤波 | 边缘保留平滑、抑制毛刺 | 需调参几何与属性标准差 | RGB-D 深度图去噪、表面重建 |
6.1 工业库选择建议:Open3D vs PCL
在工程落地中,滤波算法是调用最频繁的基础算子。如何选择实现库?
- Python + Open3D:
- 适用场景:算法原型验证、深度学习数据预处理、单帧点云分析。
- 优势:API 极其简洁,矩阵转换为 NumPy 极为方便,利用 Python 的广播机制可轻易实现自定义滤波逻辑。
- 劣势:在大规模批处理时受限于 Python 的 GIL(全局解释器锁),无法榨干多核 CPU 性能。
- C++ + PCL (Point Cloud Library):
- 适用场景:自动驾驶车端部署、SLAM 实时建图、工业级大规模并行处理。
- 优势:底层的 KD-Tree 和八叉树经过高度优化,支持 OpenMP 多线程加速。
- 劣势:模板元编程导致编译极慢,API 相对繁琐(需频繁使用
Ptr智能指针)。
6.2 滤波流水线最佳实践 (Pipeline Best Practices)
在真实工业场景中,单一滤波器通常无法解决所有问题,标准做法是串联多个滤波算子组成流水线(Pipeline)。 例如,针对自动驾驶室外 LiDAR 采集到的 10 万级规模原始点云,标准的预处理流水线通常如下:
- 直通滤波 (PassThrough / Crop):首先粗暴地切除 ROI(感兴趣区域)之外的点(例如直接丢弃 或 的非道路区域),极大减小数据量。
- 体素降采样 (Voxel Grid):使用 的网格将密度均匀化,进一步降低计算量。
- 统计滤波 (SOR):对降采样后留下的点进行精细的高斯噪声去除。
- 输出:进入后续的地面分割或目标检测模块。